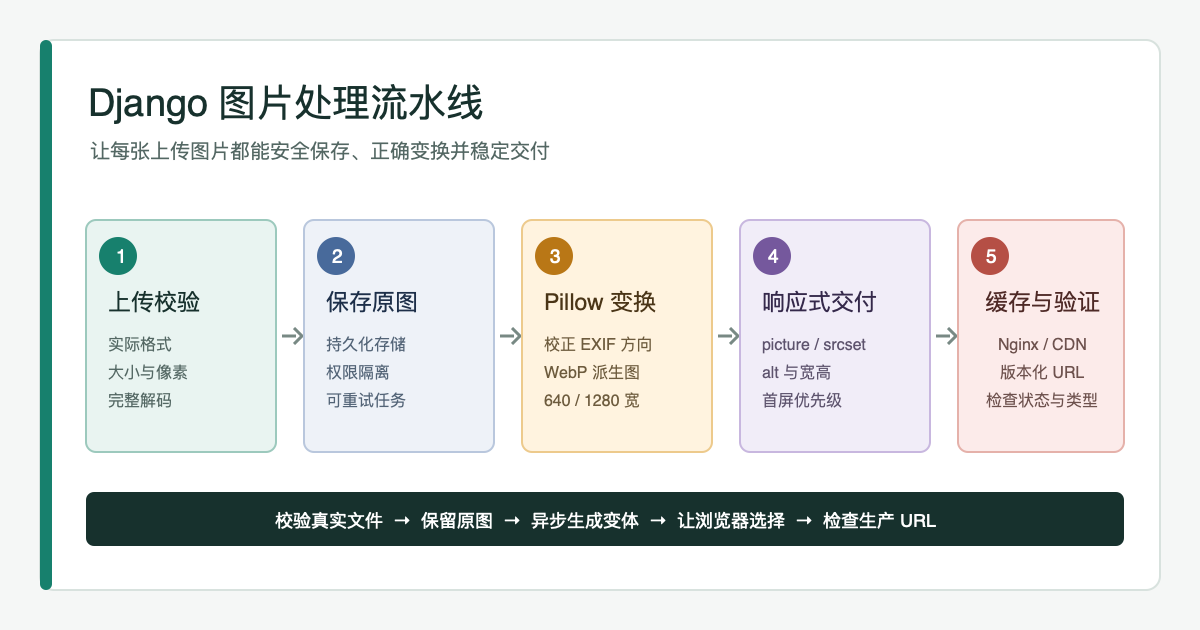
上传成功不等于图片已经能在网站上正确显示。一个完整的 Django 图片流程至少要覆盖:限制和解码用户上传、保存原图、生成合适尺寸的派生图、在页面选择正确资源、为版面预留空间,以及验证生产环境的媒体 URL。
本文聚焦 Django 服务端的媒体处理链路。HTML srcset 的基础用法可结合站内的响应式图片实践和HTML 图片加载优化;这里继续解决原图上传后怎样稳定地产出并交付图片。页面级的 canonical、robots、结构化数据等检查,可以配合Django SEO 发布前检查;更广泛的加载性能诊断见网站性能优化实战。
先定位图片为什么显示异常
浏览器里出现裂图时,不要先改 CSS。打开开发者工具的 Network 面板,选中图片请求,按顺序检查:
| 检查项 | 正常情况 | 常见问题 |
|---|---|---|
| 图片 URL | 指向当前站点可访问的 /media/... 地址 |
数据库保存了本机路径、旧域名或重复的 media/ 前缀 |
| HTTP 状态 | 图片请求返回 200 或可预期的 304 |
404 常见于文件未部署;403 常见于目录权限或 Nginx 规则 |
Content-Type |
image/jpeg、image/png、image/webp 等 |
返回 text/html 通常是错误页、登录页或代理回退页 |
| 响应内容 | 文件大小合理,能被浏览器解码 | 空文件、截断上传、扩展名与实际格式不一致 |
| 布局尺寸 | 图片容器有明确宽高比或宽高属性 | 图片加载前后高度变化,造成布局偏移 |
本地开发时,MEDIA_URL 和 MEDIA_ROOT 分别表示媒体 URL 前缀和文件保存目录。开发服务器可以临时提供媒体文件;生产环境通常由 Nginx、对象存储或 CDN 提供。Django 官方文档也明确区分了静态资源与用户上传的媒体资源:Managing files和静态文件部署值得先读一遍。
# settings.py:仅用于本地开发配置
MEDIA_URL = "/media/"
MEDIA_ROOT = BASE_DIR / "media"
MEDIA_ROOT 是服务器文件系统路径,不应该写进 <img src>。模板应使用 Django 存储后端生成的公开 URL:{{ image.file.url }}。如果本地正常而线上 404,优先确认上传目录是否持久化、部署用户是否有读权限、Nginx 的 alias 是否对应真实目录,以及反向代理是否保留了正确的路径。部署侧还可参考站内的Django 项目部署指南和静态文件 CDN 配置。不要为了“修好图片”把整个项目目录开放给 Web 服务器。
上传前先验证文件内容
浏览器提交的文件名和 Content-Type 都由客户端提供,不能作为安全判断依据。更可靠的做法是限制体积、让 Pillow 识别实际图像格式、执行解码,并限制像素总数。图片炸弹或特别大的压缩图片可能在解码时消耗大量内存,因此限制像素数和请求大小都很重要。
下面的表单示例只接受 JPEG、PNG 和 WebP,最大文件 8 MiB,最大 4000 万像素。上线前应按自己的图片用途调整阈值,并将错误提示转成用户能理解的语言。
# images/forms.py
from PIL import Image, UnidentifiedImageError
from django import forms

MAX_UPLOAD_BYTES = 8 * 1024 * 1024
MAX_IMAGE_PIXELS = 40_000_000
ALLOWED_FORMATS = {"JPEG", "PNG", "WEBP"}


class ImageUploadForm(forms.Form):
    image = forms.ImageField()

    def clean_image(self):
        uploaded = self.cleaned_data["image"]
        if uploaded.size > MAX_UPLOAD_BYTES:
            raise forms.ValidationError("图片不能超过 8 MiB。")

        try:
            uploaded.seek(0)
            with Image.open(uploaded) as probe:
                if probe.format not in ALLOWED_FORMATS:
                    raise forms.ValidationError("仅支持 JPEG、PNG 和 WebP 图片。")
                if probe.width * probe.height > MAX_IMAGE_PIXELS:
                    raise forms.ValidationError("图片像素过大,请先缩小后再上传。")
                probe.verify()
            uploaded.seek(0)
            with Image.open(uploaded) as decoded:
                decoded.load()
        except (UnidentifiedImageError, OSError, Image.DecompressionBombError):
            raise forms.ValidationError("文件不是有效或可完整解码的图片。")
        finally:
            uploaded.seek(0)
        return uploaded
ImageField 的验证适合用来做表单层的第一道检查,但它不能代替请求体大小限制、用户权限校验、CSRF 防护或存储隔离。若图片上传属于公开功能,还要考虑频率限制、配额、病毒扫描需求和失败清理。不要允许用户上传可被服务器执行的文件;图片专用目录应关闭脚本执行。
保存原图,再生成派生尺寸
原图适合归档和重新处理,页面则应按实际展示宽度下载派生图。不要为了列表卡片把 4000 像素原图直接缩到屏幕上,也不要在每次页面请求时临时缩放。建议把变换放进上传后的后台任务,生成小图和大图;任务应可重试,并避免重复处理同一个文件。
模型中把替代文本作为独立内容字段,图片文件本身只保存文件和尺寸。width_field、height_field 能在文件保存时记录原图尺寸:
# images/models.py
from django.db import models


class ArticleImage(models.Model):
    file = models.ImageField(
        upload_to="uploads/%Y/%m/",
        width_field="width",
        height_field="height",
    )
    width = models.PositiveIntegerField(null=True, editable=False)
    height = models.PositiveIntegerField(null=True, editable=False)
    alt_text = models.CharField(max_length=180, blank=True)
    small_webp = models.ImageField(
        upload_to="derived/", width_field="small_webp_width", height_field="small_webp_height", blank=True
    )
    small_webp_width = models.PositiveIntegerField(null=True, editable=False)
    small_webp_height = models.PositiveIntegerField(null=True, editable=False)
    large_webp = models.ImageField(
        upload_to="derived/", width_field="large_webp_width", height_field="large_webp_height", blank=True
    )
    large_webp_width = models.PositiveIntegerField(null=True, editable=False)
    large_webp_height = models.PositiveIntegerField(null=True, editable=False)

    def __str__(self):
        return self.file.name
下面是一个可放进任务函数的 Pillow 处理核心。示例使用 Pillow 9.1 或更高版本提供的 Image.Resampling.LANCZOS;它适用于 Django 配置的文件存储,不依赖 .path,因此也能在不提供本地文件路径的对象存储后端中工作。小图和大图都从同一份解码后的源图生成;thumbnail() 保持宽高比且不会把小图放大。
# images/services.py
from io import BytesIO
from pathlib import PurePosixPath

from PIL import Image, ImageOps
from django.core.files.base import ContentFile


def build_webp_variants(article_image):
    storage = article_image.file.storage
    with article_image.file.open("rb") as source_file:
        with Image.open(source_file) as opened:
            opened.load()
            source = ImageOps.exif_transpose(opened)
            if source.mode not in ("RGB", "RGBA"):
                source = source.convert("RGBA" if "transparency" in source.info else "RGB")

            stem = PurePosixPath(article_image.file.name).stem
            outputs = {}
            for label, max_width in (("small_webp", 640), ("large_webp", 1280)):
                variant = source.copy()
                variant.thumbnail((max_width, max_width), Image.Resampling.LANCZOS)
                buffer = BytesIO()
                variant.save(buffer, format="WEBP", quality=82, method=6)

                path = f"derived/{article_image.pk}/{stem}-{max_width}.webp"
                if storage.exists(path):
                    storage.delete(path)
                outputs[label] = storage.save(path, ContentFile(buffer.getvalue()))

    article_image.small_webp.name = outputs["small_webp"]
    article_image.large_webp.name = outputs["large_webp"]
    article_image.save(update_fields=["small_webp", "small_webp_width", "small_webp_height", "large_webp", "large_webp_width", "large_webp_height"])
    return outputs
在实际项目里,建议通过 Celery、Django-Q 或其他任务队列异步调用处理函数,并将任务放到数据库事务提交后执行。要捕获编码或存储错误,记录任务状态,并避免用户反复点击造成多份派生图。上面的例子展示的是图片变换和存储边界;如果需要多租户隔离、重复文件去重或对象存储生命周期策略,应按实际系统补上对应字段和权限规则。
WebP 通常适合作为通用派生格式;AVIF 压缩率可能更好,但 Pillow、系统库和图像 CDN 的支持取决于部署环境。不要在本地能保存就假设线上也支持 AVIF。先在目标环境检查编解码能力、生成成功率和浏览器回退,再决定是否加入 AVIF。原图格式始终作为回退来源,遇到透明通道和色彩配置时也要实际抽样比对。
在模板里交付正确的尺寸
现代浏览器可以依据 srcset 和 sizes 选择适合当前视口的资源。width、height 属性应描述内容的固有宽高比例,让浏览器在文件下载前预留空间;CSS 则控制图片如何适配容器。
<picture class="article-image">
  {% if image.small_webp and image.large_webp %}
  <source
    type="image/webp"
    srcset="{% if image.small_webp_width < image.large_webp_width %}{{ image.small_webp.url }} {{ image.small_webp_width }}w, {% endif %}{{ image.large_webp.url }} {{ image.large_webp_width }}w"
    sizes="(max-width: 768px) calc(100vw - 32px), 720px">
  {% endif %}
  <img
    src="{{ image.file.url }}"
    width="{{ image.width }}"
    height="{{ image.height }}"
    alt="{{ image.alt_text }}"
    loading="lazy"
    decoding="async">
</picture>
.article-image {
  display: block;
  width: 100%;
  height: auto;
}

/* 只用于实际需要裁切为 16:9 的封面图 */
.article-cover {
  width: 100%;
  aspect-ratio: 16 / 9;
  object-fit: cover;
}
只有当图片确实会按 16:9 裁切时才使用这个比例;内容图不应为了整齐而被错误裁切。替代文本描述图片对理解内容有帮助的部分,装饰图片使用空 alt。不要把“Django、SEO、图片优化”等关键词串成 alt,也不要把说明文字重复写进 title 属性。
首屏最大内容绘制元素(LCP)如果是封面图,不要设置懒加载;将模板里的属性改为 loading="eager" fetchpriority="high" decoding="async"。文章正文里靠后的图片通常适合 loading="lazy"、decoding="async"。懒加载应由浏览器原生属性完成,不要给所有图片都加高优先级,否则首屏竞争会更严重。详细属性可参考 MDN 的响应式图片指南和 loading 属性说明。
媒体 URL、Nginx 与缓存
生产环境中,确保媒体文件落在持久化目录中,并由 Nginx 或对象存储提供访问。Nginx 配置中的 alias 是文件系统目录,不是 URL 前缀;两者必须一一对应:
location /media/ {
    alias /srv/myblog/media/;
    try_files $uri =404;
    add_header X-Content-Type-Options nosniff always;
}
配置后先用 nginx -t 检查,再 reload;不要直接复制示例路径。上传目录内不要执行 PHP、Python 等脚本。若 Nginx 前面还有 CDN,检查缓存键是否包含正确的文件 URL,并为 404 设置较短缓存,避免上传失败后错误响应长期留在边缘节点。
对内容寻址或每次更新都会换文件名的图片,可以设置较长缓存:
location /media/derived/ {
    alias /srv/myblog/media/derived/;
    try_files $uri =404;
    add_header Cache-Control "public, max-age=31536000, immutable";
    add_header X-Content-Type-Options nosniff always;
}
只有文件 URL 不会被新内容覆盖时,才能使用 immutable。如果图片更新后仍使用同一个路径,旧缓存可能让用户长期看到旧图;此时应在 URL 中加入版本指纹,或采用较短的缓存时间。缓存策略与上传目录权限、备份和对象存储生命周期是不同问题,不能靠一个 expires 配置代替。
图片 SEO 要能被实际验证
图片 SEO 的第一步是让图片 URL 能被抓取并稳定返回正确的图片类型。对文章封面,页面的 BlogPosting 结构化数据应包含公开、可访问的图片 URL,Open Graph 图片也要指向实际图片。当前博客页面已经输出文章结构化数据,新增图片时重点检查模板是否拿到正确的存储 URL;不要为同一个对象重复输出互相矛盾的 ImageObject。
内容编辑者应逐张确认:图片与所在段落相关、alt 准确、宽高符合文件、移动端不会横向溢出;编辑器生成的 Markdown 路径应是公开 URL,而不是上传时的本机临时地址。需要定期检查历史图片 404,修复文件丢失或路径变更,并在更新文件名时同步文章内容和 Open Graph 元数据。
可以用下面这个轻量检查脚本检查文章页里的同站图片 URL。它只校验 HTTP 状态和响应类型,不会判断图片内容是否符合文章,也不会替代视觉抽查。运行时把需要检查的文章地址作为必填参数传入:
# check_page_images.py
import argparse
from html.parser import HTMLParser
from urllib.parse import urljoin, urlparse
from urllib.request import Request, urlopen

parser = argparse.ArgumentParser(description="Check same-origin article images")
parser.add_argument("page_url", help="Published article URL to inspect")
args = parser.parse_args()
parsed_page = urlparse(args.page_url)
if parsed_page.scheme not in {"http", "https"} or not parsed_page.netloc:
    parser.error("page_url must be an absolute HTTP or HTTPS URL")
PAGE_URL = args.page_url
PAGE_HOST = parsed_page.netloc


class Images(HTMLParser):
    def __init__(self):
        super().__init__()
        self.urls = []
        self.missing_alt = 0

    def handle_starttag(self, tag, attrs):
        if tag != "img":
            return
        attrs = dict(attrs)
        if "alt" not in attrs:
            self.missing_alt += 1
        candidates = [attrs.get("src", "")]
        candidates.extend(item.strip().split(" ")[0] for item in attrs.get("srcset", "").split(","))
        self.urls.extend(urljoin(PAGE_URL, url) for url in candidates if url)


request = Request(PAGE_URL, headers={"User-Agent": "BlogImageCheck/1.0"})
with urlopen(request, timeout=15) as response:
    page = response.read().decode("utf-8", errors="replace")

parser = Images()
parser.feed(page)
checked = set()
for image_url in parser.urls:
    parsed = urlparse(image_url)
    if parsed.netloc != PAGE_HOST or image_url in checked:
        continue
    checked.add(image_url)
    try:
        req = Request(image_url, headers={"User-Agent": "BlogImageCheck/1.0"})
        with urlopen(req, timeout=15) as response:
            content_type = response.headers.get_content_type()
            if response.status != 200 or not content_type.startswith("image/"):
                print("FAIL", response.status, content_type, image_url)
            else:
                print("OK", content_type, image_url)
    except Exception as exc:
        print("FAIL", type(exc).__name__, image_url)

print(f"checked={len(checked)} missing_alt={parser.missing_alt}")

# Example: python check_page_images.py https://blog.zenleak.cn/post/304/
这个脚本只读取页面 HTML 和同域图片,不会发送表单或修改站点数据。要补充尺寸与视觉检查,可以从站点内容管理系统读取图片自然宽高,在 Playwright 中检查布局偏移,并对首屏图片单独观察 LCP。不要对未知第三方页面批量扫描,也不要把结果中的 IP 或用户信息写进公开报告。
发布前核对清单
- 上传表单验证文件体积、实际格式、完整解码和像素上限;失败后没有留下孤立文件。
- 原图与派生图都保存在持久化存储中,任务失败可重试,重复执行不会产生无限份文件。
- 公网页面的图片请求返回成功状态和
image/*类型,且 URL 没有暴露临时目录或本机路径。 srcset的宽度描述符与实际变体相符;页面尺寸由width、height或正确的aspect-ratio预留。- 首屏主图未被懒加载;下方图片按需加载;封面、alt 和 Open Graph 指向同一张有效图片。
- Nginx 只开放媒体目录、关闭脚本执行;长缓存只用于不会被覆盖的版本化 URL。
- 在手机、桌面和窄屏下抽查真实文章,确认裁切、透明通道、EXIF 方向和颜色没有异常。
图片交付是一条从上传校验到浏览器显示的链路。按这条链路逐段验证,可以更快区分文件损坏、存储路径、响应头、模板尺寸和缓存问题;它能减少常见故障,但不能代替针对真实页面的设备测试和版权审查。

评论 (0)
暂无评论,快来抢沙发吧!